
Simetrik: gestión de anomalías en el Operation Center
El Operation Center de Simetrik vigila la ingesta y la conciliación de datos financieros. Diseñé la gestión de anomalías y la implementé en el frontend del producto en cinco meses y 38 pull requests: del detalle de incidente al modo Monitoreo, con una regla central, no simular inteligencia.
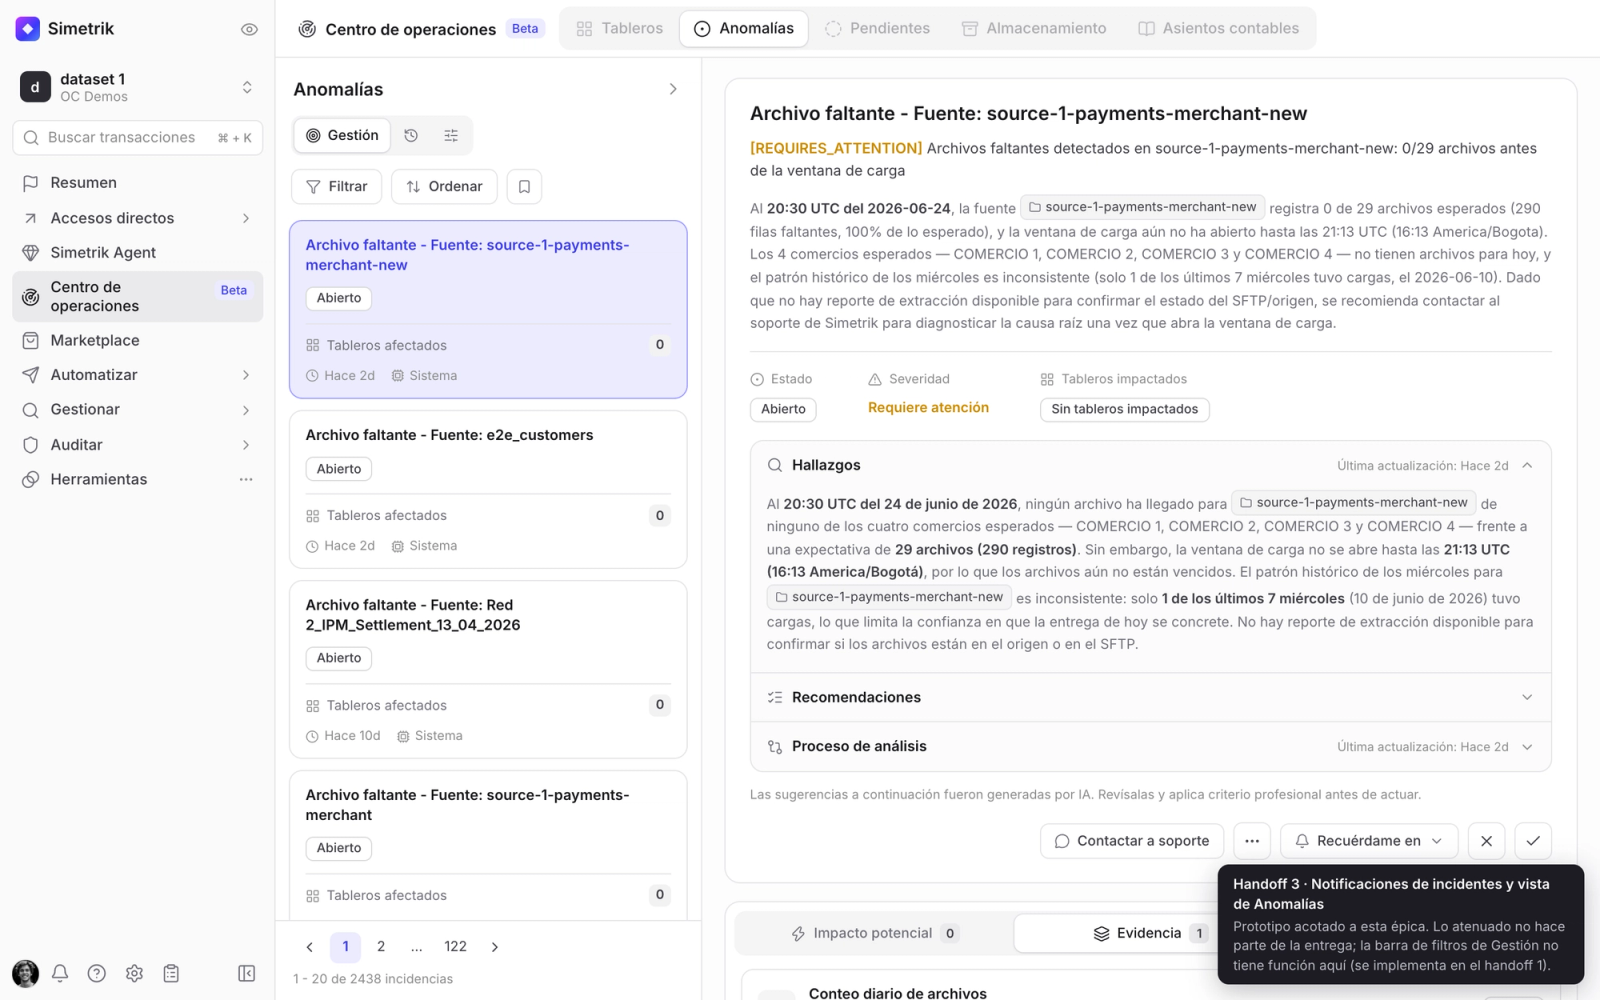
Cuando una inteligencia artificial propone la causa de un problema en un producto donde se decide sobre dinero, lo más importante que uno diseña no es la respuesta. Es la diferencia entre lo que se sabe y lo que se cree.
Simetrik concilia datos financieros para empresas: toma lo que entra desde bancos, pasarelas y sistemas internos, y verifica que cuadre. El Operation Center es la parte del producto que vigila que esa ingesta y esa conciliación funcionen. Cuando algo se desvía, porque cae el volumen de una fuente, un indicador se sale de rango o una conciliación deja de cuadrar, alguien tiene que enterarse, entender qué pasó y decidir qué hacer.
Antes, eso vivía en la cabeza de los operadores y en alertas sueltas. Entre marzo y julio de 2026 diseñé la gestión de anomalías y la implementé yo mismo en el frontend del producto: 38 pull requests en React y TypeScript, en tres idiomas, sobre el sistema de diseño de la empresa.
Lo que construí, mes a mes
| Mes | Qué salió al producto |
|---|---|
| Marzo | Chat de investigación de anomalías: pasos de investigación, causa raíz, recomendaciones y una tarjeta de decisión |
| Abril | Diálogo de monitoreo inteligente con series agrupadas y umbrales por serie, y el Centro de Anomalías en formato maestro-detalle conectado a la API |
| Mayo | Incidentes unificados entre el gráfico, el diálogo y la lista; estados vacíos contextuales, onboarding y errores de página completa |
| Junio | Modo Monitoreo del tablero: pestañas de Ingesta y de Gráficos con sus cards y filtros |
| Julio | Configuración a nivel de cuenta, notificaciones de incidentes, auditoría de UI con modo oscuro y movimiento, y la migración a un endpoint paginado |
Todo se diseñó primero como prototipos HTML navegables y después lo llevé al código. Las imágenes de este caso vienen de esos prototipos, con datos de ejemplo.
Un ciclo completo, no una alerta
La primera decisión fue tratar cada anomalía como un incidente con ciclo de vida, no como una notificación: detección y configuración, triage, diagnóstico, acción y aprendizaje. En el producto eso es una página con cuatro vistas, Gestión, Historial, Recursos y Configuración, y un modo Monitoreo dentro de cada tablero.
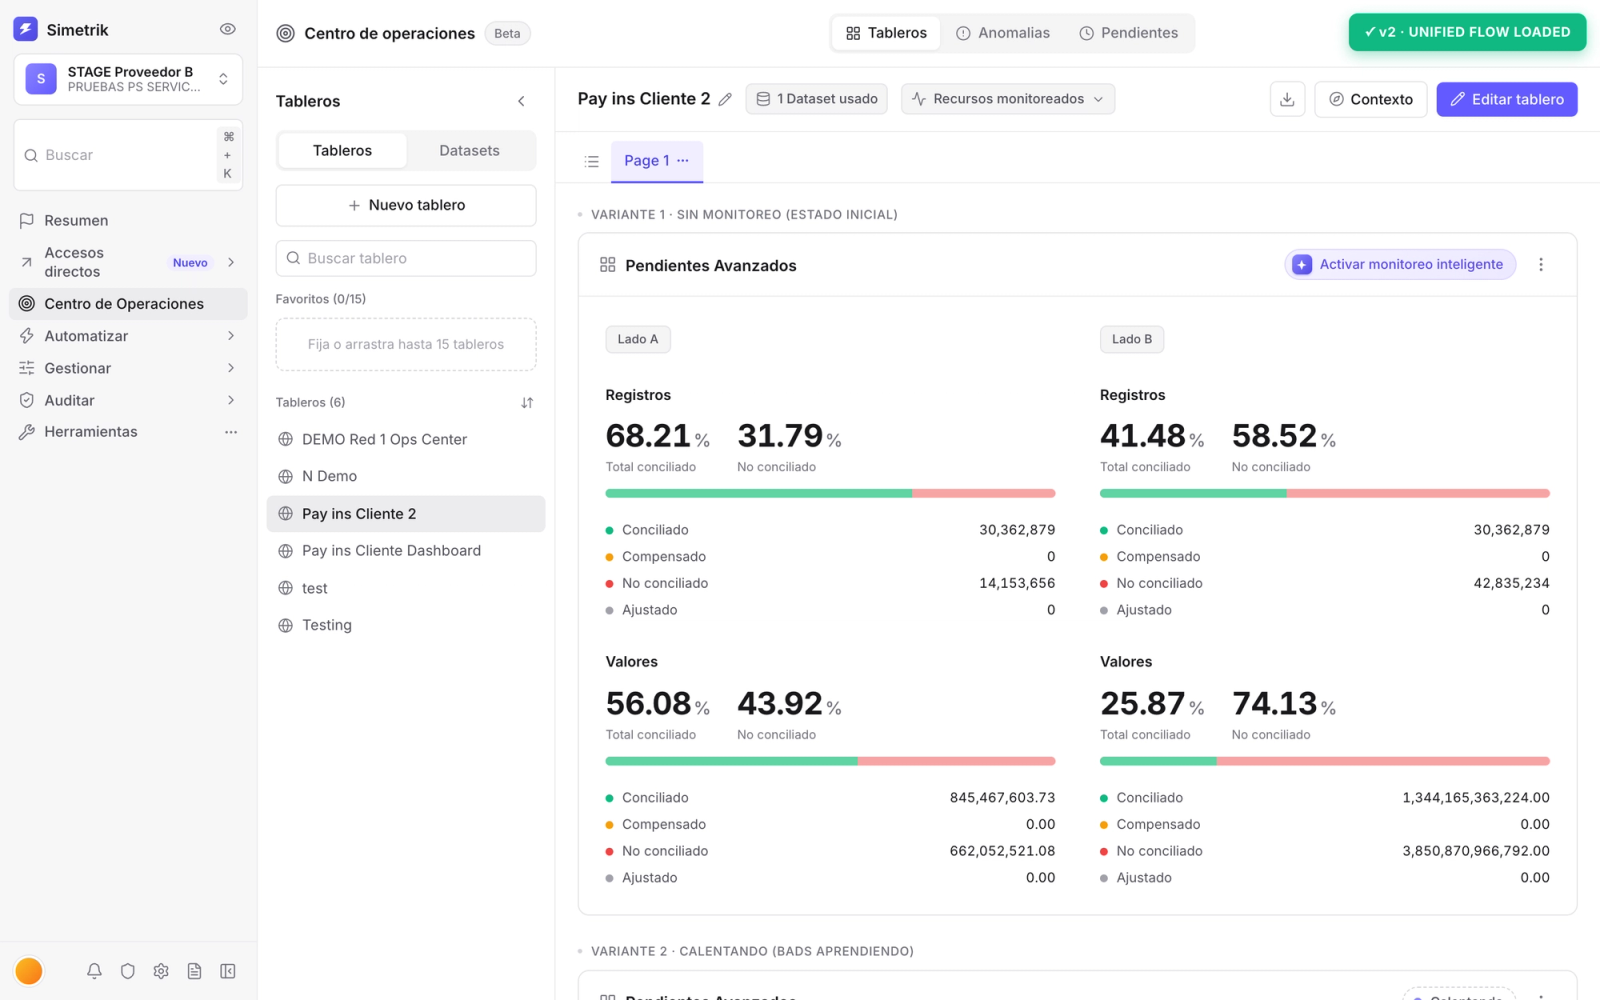
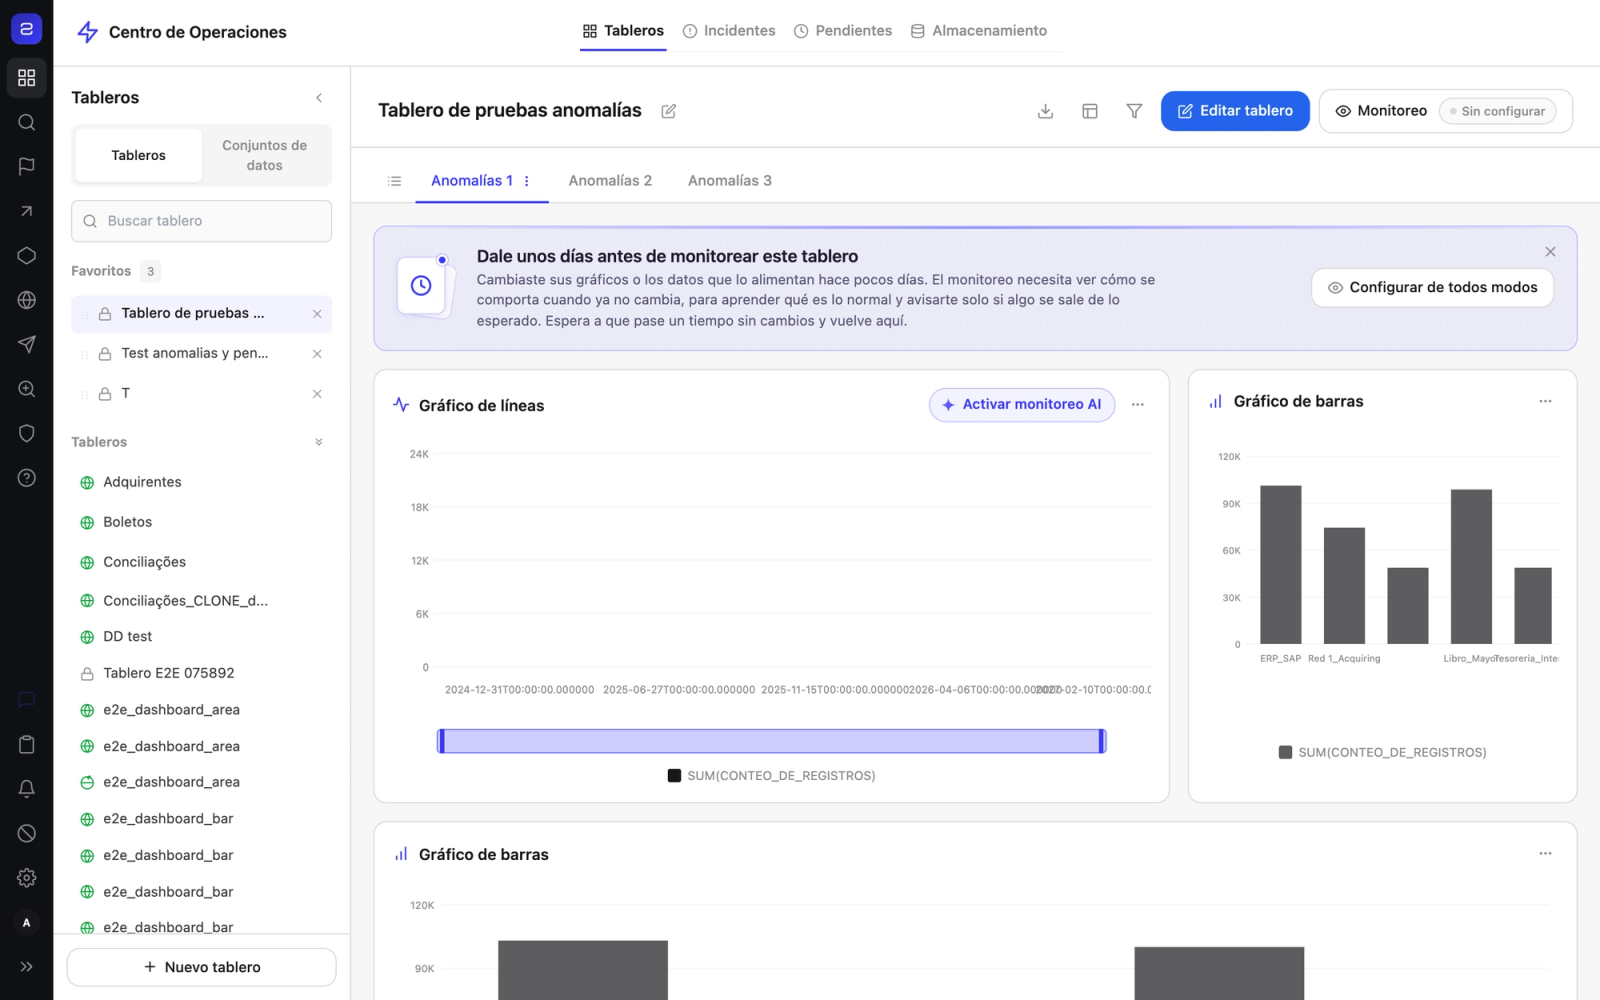
La configuración vive donde está el dato. El monitoreo se activa sobre cada gráfico del tablero, y en julio lo llevé también a nivel de cuenta, por categorías, para no tener que entrar tablero por tablero.
Hipótesis no es hallazgo
En un producto financiero, una inferencia con el mismo peso visual que un dato verificado es un riesgo: el operador puede actuar sobre algo que nadie comprobó. Por eso los hallazgos, lo que el sistema observó en los datos, y las hipótesis, lo que la inteligencia artificial cree que los explica, son componentes distintos con tratamientos distintos. Y todo lo generado lleva un aviso: son sugerencias, hay que revisarlas antes de actuar.
Honestidad del análisis
Esta es la decisión de la que más aprendí, porque tuve que corregirme. En abril construí unos pasos de «razonamiento» que aparecían mientras cargaba el análisis: la interfaz mostraba a la inteligencia artificial pensando. En julio los retiré. Avanzaban con temporizadores que no tenían relación con el trabajo real; eran una animación que simulaba inteligencia.
Los reemplacé por un indicador de una línea atado a la petición en curso. La marca de IA quedó solo sobre la narrativa, que es lo único que genera un modelo. Y «Análisis AI» pasó a llamarse «Análisis de línea base», porque en realidad es un cálculo estadístico. Nombrar las cosas por lo que son también es diseño de confianza.
Notificar menos, pero mejor
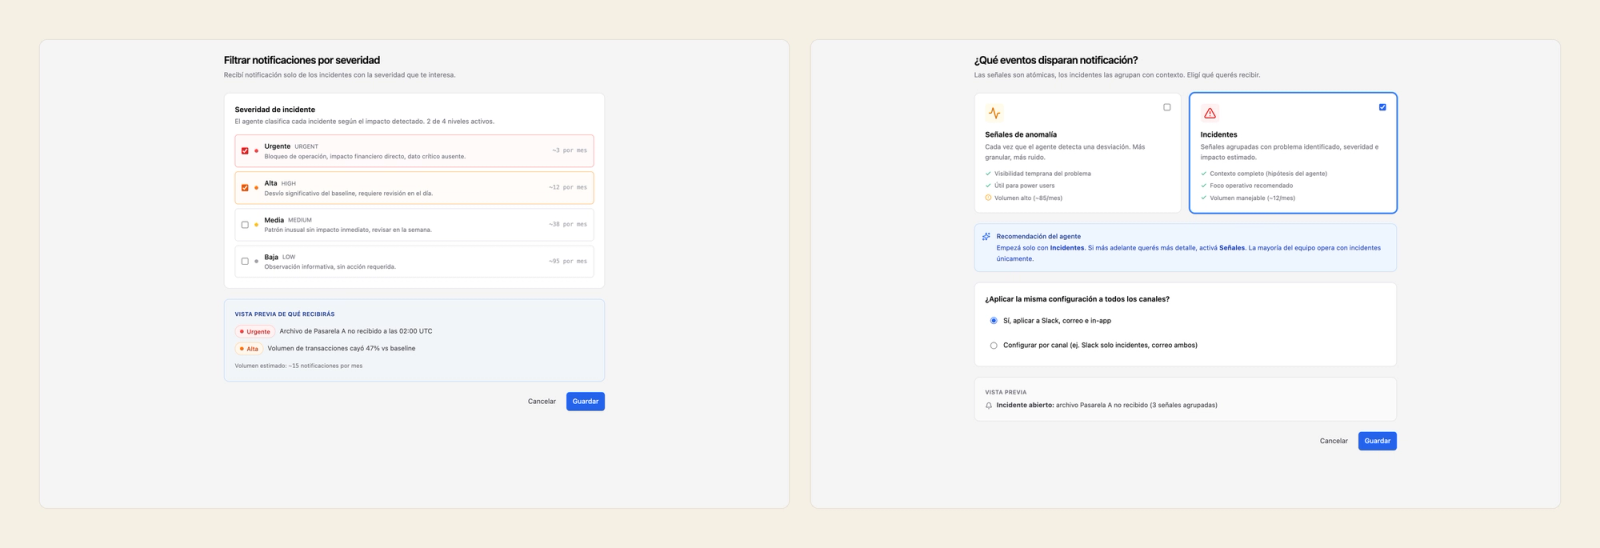
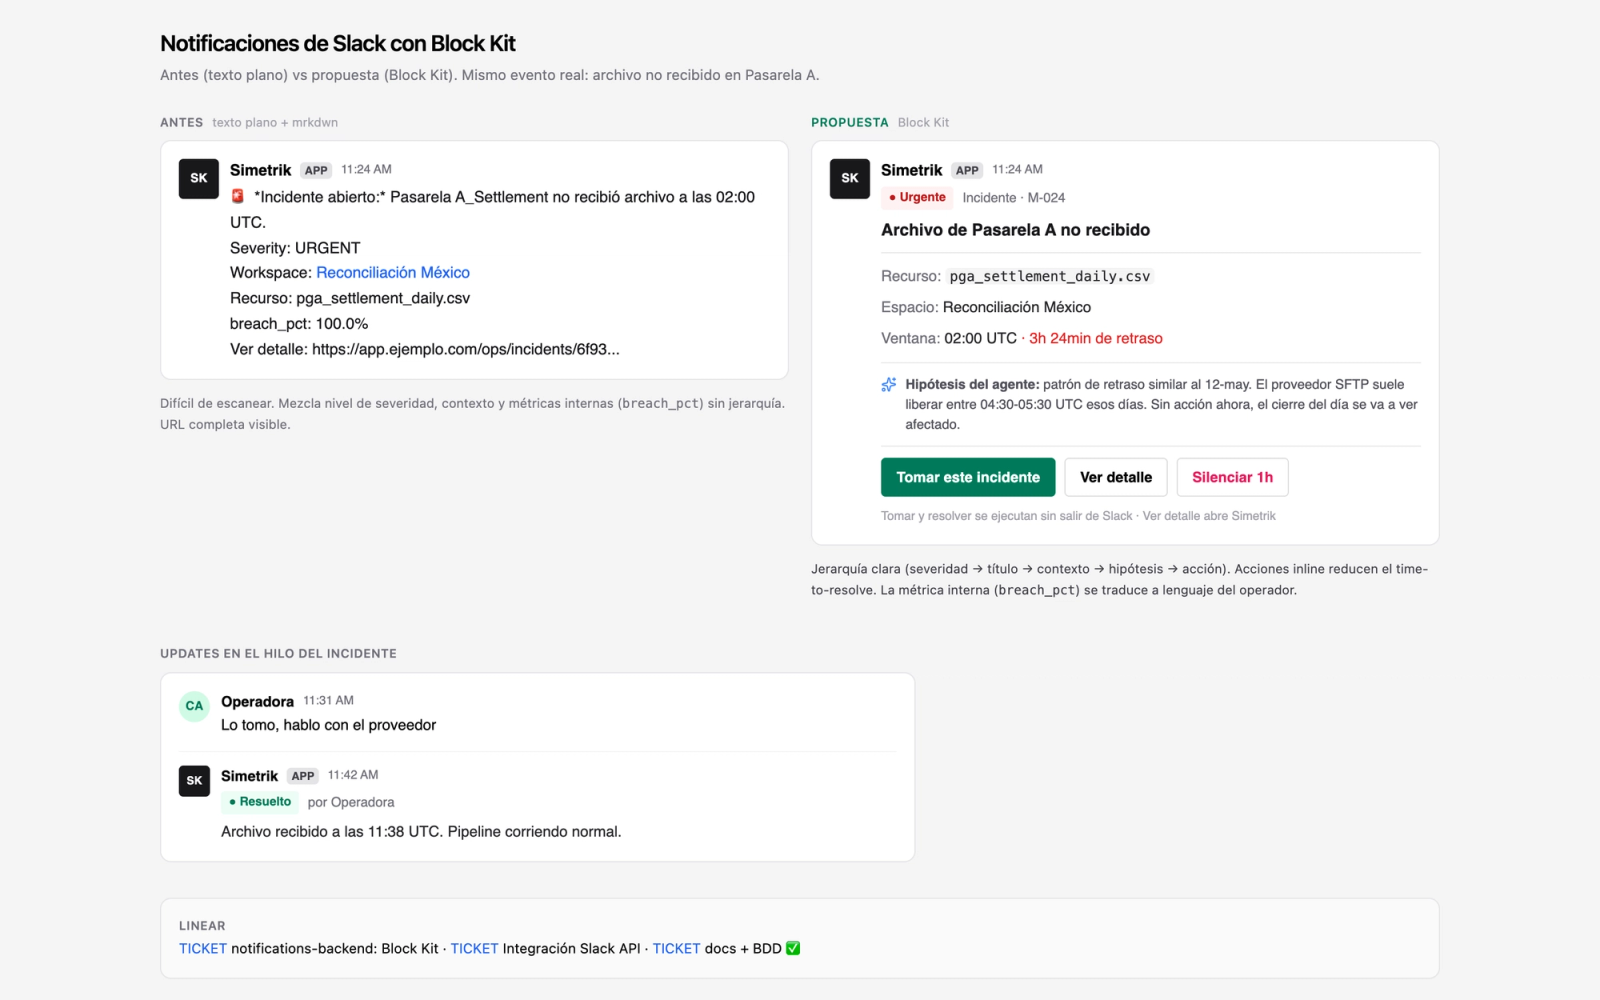
Una anomalía que nadie ve no sirve, y cien notificaciones al día tampoco. Las reglas de notificación permiten elegir por severidad y entre señales sueltas o incidentes que ya agrupan varias señales con su contexto; la recomendación por defecto es empezar solo con incidentes. En julio implementé las notificaciones de incidentes como paquetes editables, con un primer uso que explica el concepto con un diagrama y plantillas.
Los detalles que sostienen la experiencia
- —Palabras que no se repiten ni se contradicen: «Métricas de gráficos» pasó a «Monitoreo de gráficos» y los estados a «Activo» y «Sin configurar», para no terminar leyendo «Monitoreo Monitoreo activo».
- —Estados vacíos con nombre y bien priorizados: si hay una búsqueda activa, su vacío manda sobre el de los filtros, y no se ofrece «limpiar filtros» cuando eso no resolvería nada.
- —Una auditoría de UI con 34 hallazgos que migró colores fijos a tokens, lo que de paso arregló el modo oscuro, y puso las animaciones detrás de la preferencia de movimiento reducido.
- —Teclado: anillos de foco visibles, controles inertes mientras carga y el motivo de un control deshabilitado expuesto al lector de pantalla, porque el tooltip solo lo abre un puntero.
- —Un marco de carga único para cargar, fallar y mostrar, para que la interfaz no salte ni se reordene cuando llegan los datos.
Cuando la pantalla descubrió que faltaba un dato
La vista de monitores de gráficos llenaba su lista encadenando peticiones: los tableros, luego las páginas de cada tablero, luego el estado de cada gráfico. Por encima de cierto número de tableros, algunos gráficos simplemente no aparecían, ni siquiera en la búsqueda.
En lugar de recortar el alcance de la pantalla, lo resolví en el origen: diseñé e implementé un endpoint paginado que devuelve los gráficos con su estado de monitoreo ya derivado en el servidor, con los mismos valores que la interfaz usaba, y lo consumí en el frontend. Si llega un estado desconocido, la interfaz cae a «sin configurar», que es la lectura segura. Elegí «Cargar más» en vez de scroll infinito porque el contenedor de scroll lo comparten otras categorías.
Cómo trabajé
Trabajé con Claude Code como par, casi todos mis commits llevan su coautoría, y con dos revisores: un bot de revisión automática y una persona del equipo. Aprendí a pasar primero el bot y a filtrar sus sugerencias por alcance, porque el bot revisa archivos y la persona revisa el alcance del cambio. Los ajustes finos de espaciado los hice en Ohana, mi herramienta para señalar sobre la interfaz, y cada cambio quedó explicado en el changelog con su porqué.
Lo que aprendí
Que no hay que simular inteligencia. Una interfaz que finge pensar gana un segundo de impresión y pierde la confianza del que decide. La confianza viene de marcar con claridad qué es dato, qué es cálculo y qué es inferencia.
Que cuando falta un dato, se arregla en el origen. Negociar hacia abajo el alcance de una pantalla es más fácil, pero deja al usuario con una vista que miente por omisión.
Y que diseñar el ciclo completo cambia la conversación. Una alerta pregunta qué pasó; un incidente con ciclo de vida también pregunta quién lo tomó, qué se hizo y qué se aprendió.