
Nugget: investigación atómica en markdown, git y agentes
Una herramienta de código abierto para hacer investigación atómica sin SaaS: el repositorio es markdown en git, se explora en Obsidian, la confianza de cada insight se calcula con una fórmula y cuatro agentes de Claude Code hacen el trabajo pesado.
Un repositorio de investigación no debería ser un cementerio en Notion ni una suscripción que no puedes pagar. Debería ser tuyo: texto plano, versionado y consultable.
Nugget es una herramienta de código abierto para hacer investigación atómica, la metodología de Daniel Pidcock detrás de Glean.ly, sin depender de un SaaS. El repositorio de investigación es un repositorio de git con markdown estructurado; se explora en Obsidian; los cálculos los hacen scripts en TypeScript; y la extracción de facts y la búsqueda de patrones la hacen agentes especializados de Claude Code.
La hice porque no existía una alternativa abierta a Dovetail o Glean.ly, y los equipos terminan pagando caro o usando Notion como un lugar donde la investigación se guarda y no se vuelve a leer.
El modelo atómico
La idea central es partir la investigación en piezas de una sola idea. Un experimento es lo que se hizo. Un fact es lo que se vio, sin interpretación. Un insight es lo que se cree que explica esos facts, y cambia con la evidencia nueva. Un theme agrupa insights cuando aparece un patrón. Y una recomendación es lo que se propone hacer. Las relaciones son de muchos a muchos: un fact puede sostener varios insights, y un insight junta facts de distintos experimentos.
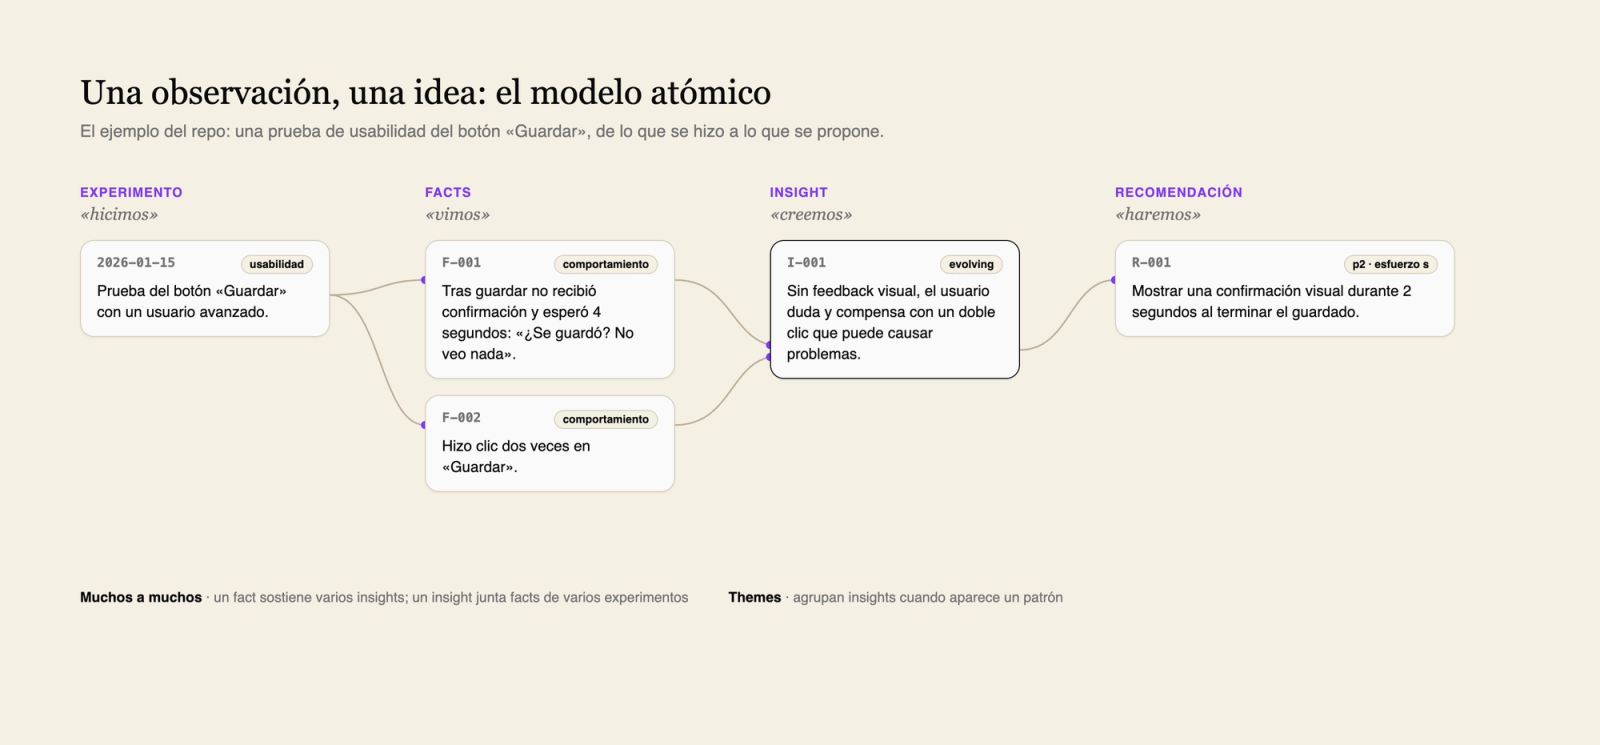
Cada entidad es un archivo markdown con su frontmatter. Las relaciones son enlaces de Obsidian, así que el grafo se dibuja solo, y las consultas se hacen con Dataview.
---
id: F-001
experiment: "[[2026-01-15-save-button-usability]]"
participant: "[[P-001-power-user]]"
evidence_type: observed_behavior
sentiment: negative
supports_insights:
  - "[[I-001-save-button-feedback-missing]]"
contradicts_insights: []
tags:
  area: [configuracion]
  theme: [feedback]
created_at: 2026-01-15
---

# F-001

**Tras presionar el botón "Guardar", el participante no recibió
ninguna confirmación visual y mantuvo la mirada esperando feedback
durante 4 segundos.**

> "¿Se guardó? No veo nada."
Una confianza que se calcula, no que se opina
Cada insight tiene un puntaje de confianza, y lo calcula una fórmula determinística, no un modelo. Suma el peso de los facts que lo sostienen según el tipo de evidencia y su antigüedad, resta los que lo contradicen, premia que la evidencia venga de varios experimentos y penaliza el insight que lleva más de seis meses sin evidencia nueva.
confidence(insight) =
    Σ facts a favor     (peso × recencia)
  − Σ facts en contra   (peso × 0,8 × recencia)
  + bono de diversidad  (5 por cada experimento adicional)
  − penalización por antigüedad (después de 180 días sin evidencia nueva)

pesos:  usability_test 12 · interview 10 · analytics 8
        survey 6 · support_ticket 4 · heuristic_eval 2
Así se ve al correrlo hoy sobre el ejemplo del repo. La evidencia es de enero y el insight no se ha revalidado, así que la penalización por antigüedad se come todo el puntaje. Eso es exactamente lo que tiene que decir: ese insight necesita evidencia nueva antes de sostener una decisión.
Cuatro agentes y una persona que decide
El trabajo pesado lo hacen cuatro agentes de Claude Code, cada uno con un solo trabajo y su propio contexto: uno trae la fuente, otro la vuelve atómica, otro busca patrones y otro audita. Un orquestador detecta la intención y delega.
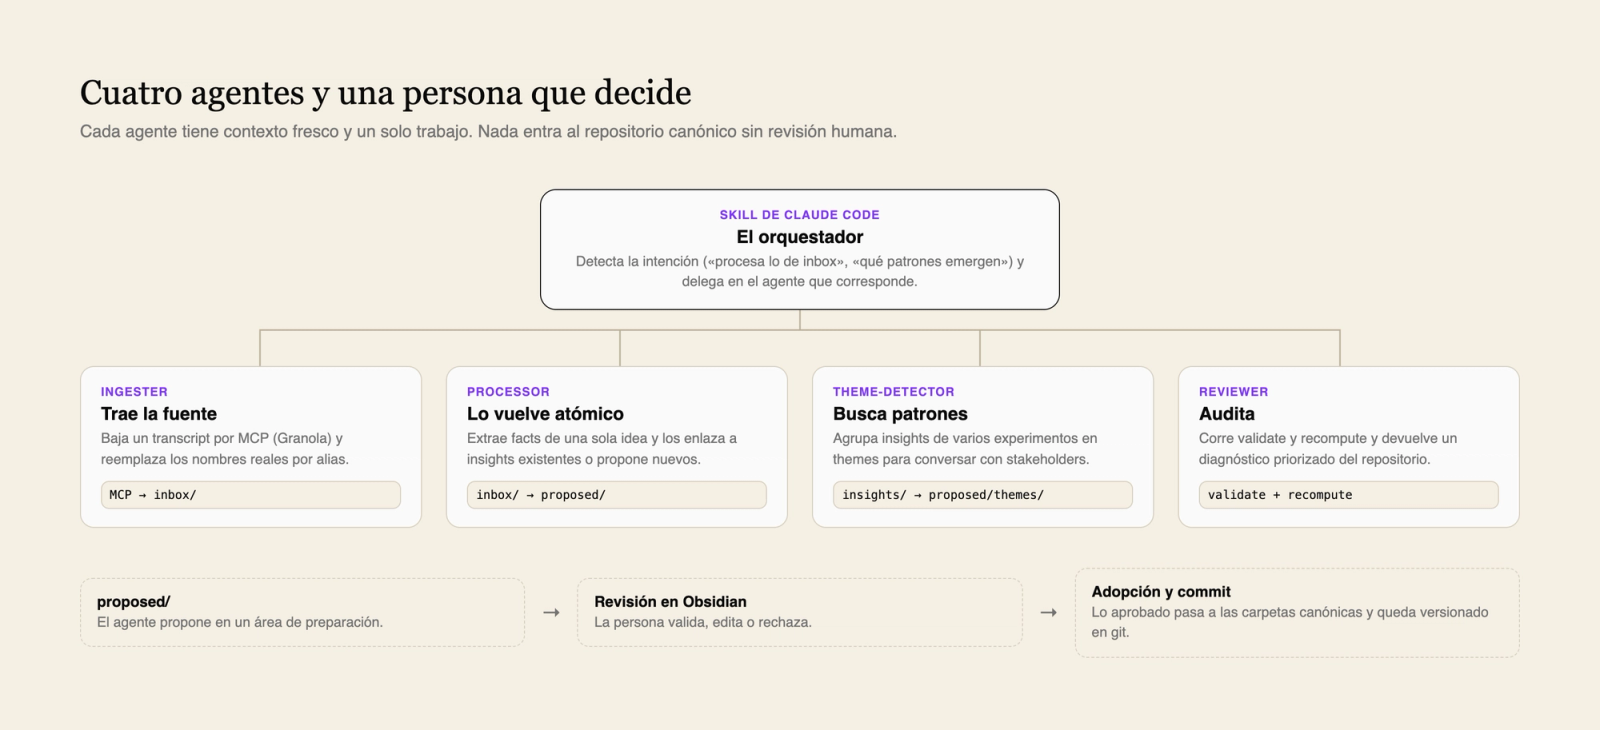
La regla más importante es que los agentes proponen y la persona decide. Todo lo que producen cae en una carpeta de preparación, se revisa en Obsidian y solo lo aprobado pasa a las carpetas canónicas y queda en git. El flujo se maneja en lenguaje natural desde Claude Code:
Los datos personales nunca entran
En los archivos canónicos nunca van nombres reales: siempre alias, como «Usuario avanzado #1». El mapeo real vive en un archivo local que git ignora. Y el validador lo hace cumplir: si alguien pega un correo en un fact, lo detiene.
El validador también revisa el esquema de cada entidad, que las etiquetas existan en la taxonomía, que los enlaces apunten a algo y que las relaciones sean simétricas: si un fact dice que sostiene un insight, el insight tiene que decir lo mismo.
Empezar
Nugget es una plantilla: se clona, se desconecta del original y se conecta a un repositorio propio, normalmente privado. La taxonomía de etiquetas se ajusta al producto en un solo archivo.
Stack
| Capa | Herramienta |
|---|---|
| Almacenamiento | Markdown con frontmatter YAML en un repositorio de git |
| Exploración | Obsidian, con enlaces como grafo y Dataview para las consultas |
| Scripts | TypeScript con Bun, esquemas en Zod, pruebas con Vitest (66 pruebas) |
| Agentes | Claude Code: un orquestador y cuatro agentes especializados |
| Ingesta | MCP de Granola; Notion, Slack y Linear en el plan |
| Licencia | MIT |
Lo que aprendí
Que el mejor formato para investigación que dure es el más aburrido: texto plano en git. Se puede leer sin la herramienta, se puede versionar y no depende de que una empresa siga existiendo.
Que los números que sostienen decisiones no deben salir de un modelo. La confianza se calcula con una fórmula que cualquiera puede leer y discutir; el modelo se usa donde sí aporta, que es leer transcripts largos y proponer estructura.
Y que con agentes, la revisión humana no es un paso más: es el diseño. Proponer en una carpeta y adoptar en otra es lo que permite confiar en el resultado.